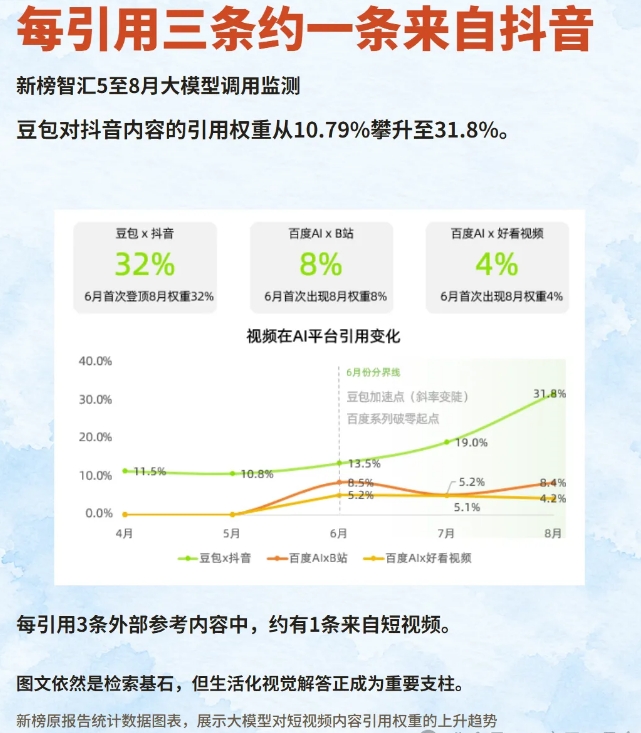
豆包引用抖音的權重升到了 31.8%,平均每引用三條內容,就有一條來自抖音。
它也牽出兩個更要命的問題:第一,這個數到底是誰、怎麼算出來的,靠不靠譜?第二,豆包這麼幹,那國內其他幾個 AI 呢,它們的”答案”又是從哪兒來的?
我花了點時間把原始報告和幾家的信源數據翻了一遍,結論挺有意思:國內這六家主流 AI,早就悄悄分成了兩撥,而你每問一個問題,其實都是在選擇讓誰替你”看世界”。
一、先給這個熱搜數字驗驗貨
先說 31.8% 是哪來的。它不是豆包官方公布的,而是一家叫新榜智匯的第三方機構測出來的。辦法說起來不覆雜:他們每天拿真實的問題去問各家 AI,都開”深度思考”模式,再把回答里實際引用的來源鏈接一條條扒出來,按域名統計被引用的次數,最後算出占比。
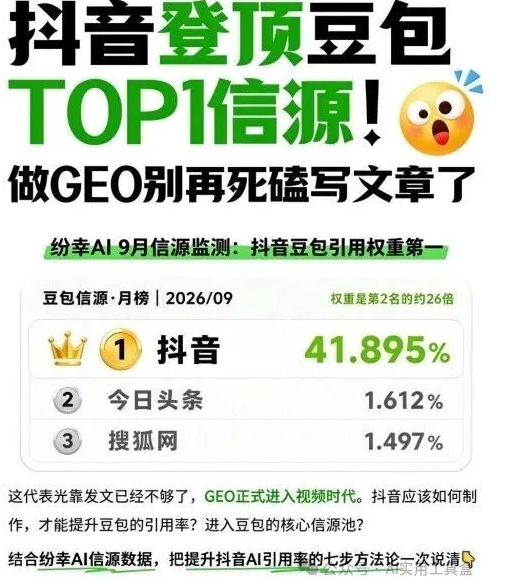
今年 5 月,豆包引用抖音的權重是 10.79%;6 月抖音第一次沖上它信源榜的第一;到 8 月變成 31.8%,三個月翻了快三倍,”每三條有一條抖音”說的就是這個月。而新榜最新一份、統計 9 月數據的報告里,這個數字已經漲到了 42%,比第二名今日頭條高出大約四成,它覆蓋的十個行業里,引用第一名清一色全是抖音。
二、國內六個AI,清清楚楚分成兩撥
搞清楚了豆包,真正有意思的問題來了:其他家呢?我把新榜 9 月那份報告里六家平台的”頭號信源”都列出來,一看,陣營分明。
第一撥,有內容爹的,背後都站著一個自家的內容帝國,回答時優先從自家池子里舀水。
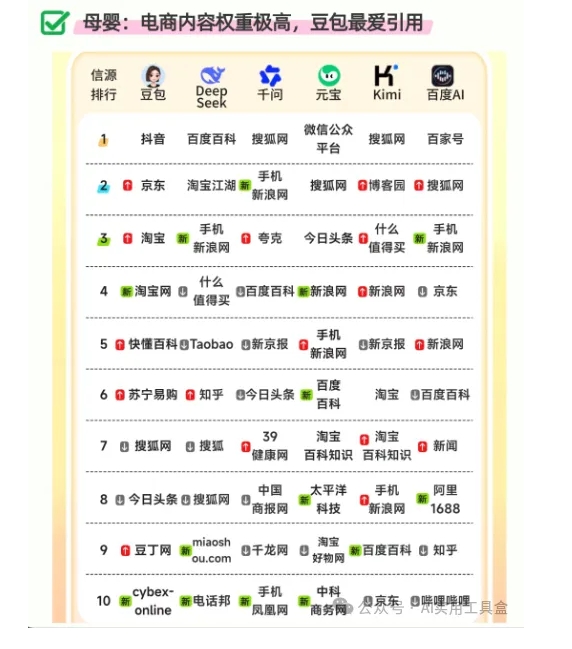
豆包是字節的,頭號信源抖音占 42%;騰訊元寶,頭號信源是微信公眾號,占 15%,十個行業里有九個的第一名都是公眾號;百度 AI 最徹底,百家號以 21% 居首,十個行業的第一名全部是百家號,百度系的入口最穩。
第二撥正好相反,是沒爹的孩子全網撿,自己手里沒有內容平台,只能到整個開放互聯網上去找素材。這三家是 DeepSeek、Kimi 和千問。
它們的數據特別能說明問題。DeepSeek 引用最多的信源是百度百科,你猜占多少?只有 3%,後面什麼值得買、淘寶江湖、手機新浪網各占 2%,前四名只差一個百分點,分散到幾乎沒有偏好。Kimi 最愛引搜狐網,5%,其次是博客園,偏好結構完整、信息密度高的深度長文。千問(阿里)排第一的是誇克,4%,百度百科 3%,十個行業居然跑出了九個不同的第一名,是六家里最沒定見、最分散的一個。
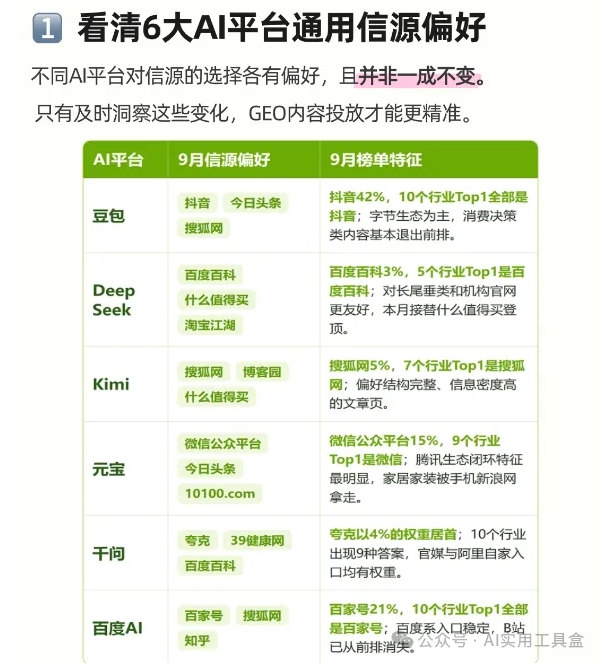 看出反差沒有:有自家生態的那三家,頭部信源動輒百分之十幾、四十幾,答案明顯帶著”自家口味”;而漫遊全網的那三家,頭號信源撐死 5%,像個誰的意見都聽一點的老好人。
豆包、元寶、百度 AI 背靠自有內容矩陣,會優先引用自家生態;DeepSeek、Kimi、千問沒有自建內容陣地,只能全網搜集,品牌想被它們選中,只能靠內容本身夠硬。
三、同一個問題,六個AI給你六種世界觀
光看百分比還不夠直觀,我拿一個很日常的場景舉例:預算兩萬,買台家用投影儀。
你拿去分別問,得到的是四種氣質完全不同的答案。問豆包,它容易給你推新品、帶貨款,一股種草味,因為它讀的多是抖音上的體驗和帶貨視頻;問元寶,它會甩給你幾篇結構完整、數據紮實的公眾號長測評;問 DeepSeek,它傾向於給你拉一張參數對比表,講技術、講結構;問百度AI,它更願意采用百家號、權威媒體和百科的口徑,一板一眼。
四個答案可能都沒錯,一個品牌可能在兩個 AI 里被反覆推薦,在另外兩個里查無此人。
海外行業里有個專門的說法叫”圍墻花園”,元寶被認為是國內最典型的一個:花園里的花是不錯,可圍墻也實實在在。公眾號文章是被官方寫進元寶信源名單里的重頭內容,微信搜一搜、搜狗在背後喂著它;騰訊也說得清楚,只用公眾號和公開網頁,不碰你的聊天和朋友圈——這點倒是坦蕩。但反過來看,你以為自己在向一個無所不知的 AI 提問,實際上你是在請它替你讀它自家花園里的那些書。
四、自家內容優先,到底是好是壞?
說到這,先別急著罵。作為一個實用主義者,我得講句公道話:AI 優先用自家生態內容,不全是壞事。
好處很實在。自家池子里的內容,版權清楚、格式統一、結構化程度高,模型抽取起來又快又準,這也是為什麼豆包現在連看圖、看視頻生成答案都很順。公眾號里那些肯下功夫的長文、抖音上大量真實用戶的一手體驗,本身就是高質量信息,比一堆內容農場強得多。
但風險同樣真實,一是信息繭房。它越懂你、越用自家內容喂你,你看到的世界就越被一個平台的調性框死。二是軟廣和種草被洗成了”客觀建議”。抖音上一條橫評,可能本身就是帶貨內容,可經過 AI 之口轉述給你,就披上了一層中立的外衣。視頻還多一道損耗:它得先把口播語音轉成文字、再識別畫面,沒字幕、口齒不清的,信息很容易就丟了或擰了。
那是不是用 DeepSeek、Kimi 這種”沒爹”的就更靠譜?也未必。你回頭看那個 3%——頭號信源才占 3%,意味著它幾乎沒有”定見”,答案高度依賴這一次檢索到了什麼。有監測團隊做過實驗,同一句話連問十次,能得到十種不同的信源組合,其中有三次,要找的品牌壓根沒出現。
五、真正的大事:你寫的內容,以後是寫給AI看的
如果你跟我一樣是做內容的,那前面這些都還只是前菜。這組數據背後,藏著一場正在發生的規則更替,跟每一個寫公眾號、拍視頻、做品牌的人都有關。
先看兩個大盤數字。中國互聯網絡信息中心的報告說,截至 2025 年 12 月,我國生成式 AI 用戶已經有 6.02 億,普及率 42.8%;艾瑞今年 7 月的調研更直接,88.6% 的消費者買東西前會先用 AI 搜一下,其中 44% 把它當成核心決策工具。
這意味著什麼?意味著越來越多的人,在認識一個品牌、決定一筆消費之前,第一個見的不是你的門店、你的廣告,而是 AI 那句”我建議你……”。如果那句話里沒有你的名字,你就是在用戶做決定的最上遊,被悄無聲息地淘汰了。
報告里有些規律,做內容的值得記下來。它發現標題里關鍵詞的覆蓋程度,是比”語義聽起來像不像”更強的引用信號;用戶怎麼問,你的標題最好就怎麼原詞出現,因為機器檢索優先認”字面有沒有這個詞”。抖音吃的是”覆蓋面”,有一條 618 筆記本橫評,一個標題里塞進”推薦、怎麼選、選購指南”加”輕薄本、全能本、大學生”,結果被 28 種不同問法引用了 199 次;而一條把型號參數堆滿、讀起來像配置單的視頻,只被引用過一次。B 站則反過來吃”精準垂直”,品牌、型號、使用場景寫清楚,哪怕語義相似度不高也能被反覆引用。還有個反常識的點:圖文比視頻更容易被豆包引用,因為圖文是現成的結構化文字,不用過語音轉寫那一關。